Clack-BASIC Compiler & 16-Bit Relais-Architektur
Hochpräzise Drei-Adress-Code Übersetzung, bitweise Arithmetik und hardwareangepasste Taktzyklen für Peter's spektakulären 16-Bit Relaiscomputer.
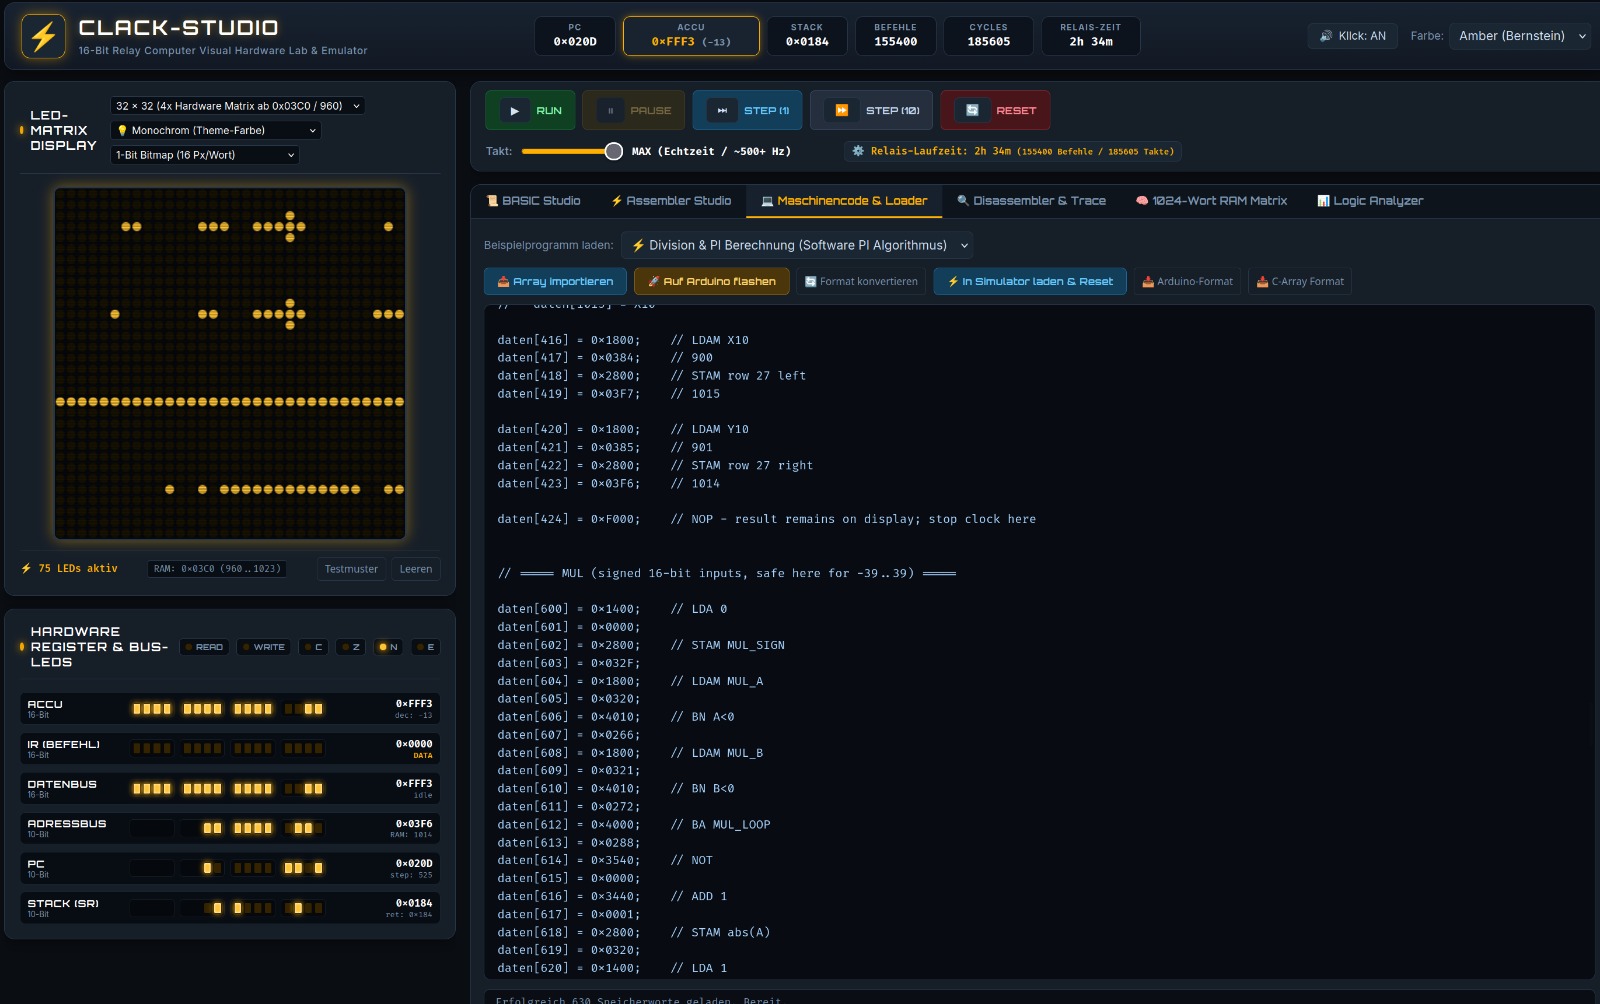
Der von Peter konstruierte Computer arbeitet mit mechanischen Schwachstromrelais für Steuerwerk, Ablauflogik und Register sowie Diodenmatrizen für die ALU. Das Systemspeicher-Subsystem (1024 × 16-Bit Worte = 2048 Bytes) sowie die Taktgenerierung sind über Arduinos angebunden. Die physische Schrittdauer beträgt ca. 70 ms pro Mikroprogramm-Schritt (jeder Schritt unterteilt in vier Taktphasen Clk0 bis Clk3), woraus sich reale Befehlslaufzeiten zwischen ~140 ms (NOP) und ~560 ms (indirekte Speicherzugriffe) ergeben.
⚙️ Register-Architektur & Akkumulator
Die CPU ist als 16-Bit Akkumulator-Maschine aufgebaut. Der Programmierer arbeitet primär mit dem Akku; die übrigen Register erfüllen spezialisierte interne Aufgaben:
ACCU(Akkumulator): Zentrales 16-Bit Arbeits- und Rechenregister für alle ALU-Operationen und Transfers.SR(Subroutine Return Register): 10-Bit Register für die Rücksprungadresse beiCALL / RET. Physisch existiert genau eine Unterprogrammebene (kein Hardware-Stack!). Verschachtelte Unterprogramme erfordern einen Compiler-Software-Stack im RAM.PC(Programmzähler): 10-Bit Register (0 bis 1023), das während der Befehlsausführung bereits auf die nächste Programmadresse bzw. das folgende Operanden-Wort zeigt.AR,AB-R,PC-HR: Interne 10-Bit Adress-, Puffer- und Hilfsregister des Steuerwerks.FLAGS: Kein klassisches Statusregister! Die FlagsN(Negativ / Bit 15),Z(Null) undE(Even / Bit 0 == 0) entstehen rein kombinatorisch direkt aus dem Akku. NurC(Carry) ist ein diskretes Register-Flipflop der ALU.
⏱️ Taktphasen & Mikroprogramm-Schritte
Ein Maschinenbefehl wird nicht in einem Einzeltakt ausgeführt, sondern durchläuft mehrere Mikroprogramm-Schritte mit je vier Taktphasen (Clk0..Clk3):
- Schrittdauer: Ca. 70 ms pro Mikroprogramm-Schritt (Master/Slave-Umschaltung und Prellzeitkompensation).
- NOP: 2 Schritte (~140 ms).
- LDA X / ADD X / Branches / CALL: 4 Schritte (~280 ms).
- RET: 5 Schritte (~350 ms).
- LDA/STA M(X): 6 Schritte (~420 ms).
- LDA/STA M(M(X)): 8 Schritte (~560 ms) für indirekte Speicherzugriffe.
Speicherbelegungsplan (1024 Worte à 16 Bit)
| Adressbereich (Hex) | Adressbereich (Dezimal) | Größe | Funktion / Zuordnung | Zugriff |
|---|---|---|---|---|
0x0000 – 0x001F |
0 – 31 | 32 Worte | Zero-Page: Schnelle Direktvariablen (A–Z), Systemregister, Temporärvariablen | Lesen / Schreiben (1 Zyklus) |
0x0020 – 0x03BF |
32 – 959 | 928 Worte | Programmcode, Datentabellen & Software-Stack: Maschinencode (Opcode- & Operanden-Worte), DATA-Wertetabellen sowie softwareverwalteter Rücksprungstapel für verschachtelte Unterprogramme. Self-Modifying Code wird aktiv zur Laufzeit genutzt! | Gemeinsamer 16-Bit Code- & Datenbereich |
0x03C0 – 0x03FF |
960 – 1023 | 64 Worte | 32×32 Relais-Matrix Framebuffer: 64 Worte à 16 Bit = 1024 Bildpunkte direkt im Hauptspeicher. Jede Zeile belegt 2 Worte (32 Bit): • Wort 0 (gerade: 960, 962, ...): rechte 16 Pixel (X: 16..31) • Wort 1 (ungerade: 961, 963, ...): linke 16 Pixel (X: 0..15) Bit 15 ist jeweils links, Bit 0 rechts. |
Memory-Mapped Display (kein separater Grafikcontroller) |
Clack-BASIC bietet wesentlich mehr Sprachoperationen, als die Relais-CPU hardwaremäßig besitzt. Die physische ALU beherrscht ausschließlich ADD, AND, OR, NOT, SHL und SHR. Es gibt keine Hardware-Befehle für Multiplikation (*), Division (/), Subtraktion oder direkte Vergleiche (CMP). Der Compiler übersetzt diese Funktionen in ausgeklügelte Software-Routinen (Multiplikation via Shift-and-Add __mul, Division via wiederholte Subtraktion, Subtraktion via Zweierkomplement NOT + 1 + ADD).
Clack-BASIC wurde speziell für die 16-Bit Wortbreite und die Eigenschaften von Peter's Relaiscomputer entwickelt. Der Compiler generiert hochoptimierten Code, bildet Variablen im RAM ab und übersetzt Schleifen und Bedingungen in die realen Sprungbefehle der Maschine.
| Befehl / Syntax | Kategorie | Beschreibung & Hardware-Abbildung |
|---|---|---|
A = 42 / DIM X AS INT16 |
Datentypen (INT16) | 16-Bit vorzeichenbehaftete Ganzzahlen im Zweierkomplement (-32768 bis +32767). Standardtyp für alle Variablen ohne Suffix. |
DIM X, Y AS FIXED8 NEU Q8.8 |
Datentypen (Festkomma) | 16-Bit Q8.8 Festkommaarithmetik (Alternativ: AS Q8.8 / AS FIXED): 1 Bit Vorzeichen, 7 Bit Vorkomma, 8 Bit Nachkomma (Skalierung 1/256 = 0.00390625, Bereich -128.000 bis +127.996). Addition/Subtraktion laufen inline in 2 ALU-Befehlen (~0,7 s), Multiplikation/Division nutzen __runtime_fmul_q88 / __runtime_fdiv_q88. |
X# = 1.5 / DIM Z AS FLOAT16 NEU CLACK-F16 |
Datentypen (Gleitkomma) | 16-Bit Gleitkomma im Zuse-Stil (S1-E7-M8) (Alternativ: AS CLACK-F16 / AS F16): 1 Bit Vorzeichen, 7 Bit Exponent (Bias 63), 8 Bit Mantisse mit impliziter führender 1 (9 Bit Präzision, Dynamikbereich ±5.4×10⁻²⁰ bis ±9.2×10+18). Unterstützt +, -, *, /, Vergleiche und gemischte Ausdrücke über die Software-FPU (__f16_add, __f16_sub, __f16_mul, __f16_div). |
FTOI(X) / ITOF(N) / ITOF16(N) NEU |
Typkonvertierung | Konvertiert zwischen Ganzzahlen und Kommazahlen: FTOI(x) / INT(x) / FIX(x) / F16TOI(x) schneidet Nachkommastellen Richtung 0 ab (→ INT16); ITOF(n) / FIXED8(n) wandelt nach Q8.8; ITOF16(n) / FLOAT16(n) wandelt nach CLACK-F16 (__f16_itof / __f16_ftoi). |
FADD / FMUL / F16ADD / F16MUL NEU |
Explizite Intrinsics | Explizite Funktionsaufrufe für Festkomma (FADD, FSUB, FMUL, FDIV, FCMP, FABS, FNEG) und CLACK-F16 Gleitkomma (F16ADD, F16SUB, F16MUL, F16DIV, F16CMP, F16ABS, F16NEG) sowie allgemeines ABS(X). |
IF A > B THEN ... ELSE ... END IF |
Kontrollfluss | Ein- und mehrzeilige bedingte Verzweigung (für INT16, FIXED8 und FLOAT16): Da die Hardware kein CMP besitzt, wertet der Compiler Vergleiche (=, <>, <, <=, >, >=) direkt über Akku-Flags in echte Sprünge (BA, BC, BN, BZ, BE) aus. |
FOR I = 10 TO 2 STEP -2 ... NEXT |
Schleifen | Hardware-optimierte Zählschleifen mit Unterstützung für positive und negative Schrittweiten (STEP) sowie dynamische Endwerte. |
GOSUB 500 ... RETURN |
Unterprogramme | Nutzt das 10-Bit SR-Register der Hardware (physisch 1 Ebene). Alle Laufzeitroutinen (__mul, __f16_add etc.) kommen mit exakt einer Hardware-CALL-Ebene ohne verschachtelte Unterprogrammaufrufe aus. |
PRINT "WERT = "; X |
Ausgabe / Debug | Gibt String-Literale und numerische Ausdrücke (verkettet mit ; oder ,) über das Ausgabe-/Debug-Register aus. |
DATA 10, 20, 30 |
Datentabellen | Definiert eine statische Wertetabelle im Programmspeicher zur sequentiellen Abarbeitung. |
READ A, B, C |
Datentabellen | Liest die nächsten Werte aus der aktuellen DATA-Tabelle in die Variablen ein und rückt den Datenzeiger vor. |
RESTORE |
Datentabellen | Setzt den internen DATA-Zeiger wieder an den Anfang der ersten DATA-Anweisung zurück. |
STOP |
Debugging / Kontrollfluss | Programmierter Haltepunkt (Breakpoint): Hält die CPU-Ausführung an und versetzt den Simulator in den Pause-Zustand zur Register- und Speicherinspektion. |
SQR(X) / SQRT(X) v1.5.5 |
Arithmetik | Ganzzahlige Quadratwurzel: 8-Schritt divisionsfreier Shift-and-Subtract Algorithmus ohne Multiplikations-/Divisionsbefehle. |
SQR(X, DEC) v1.5.5 |
Arithmetik | Festkomma-Wurzel: Berechnet Wurzeln mit bis zu 2 Dezimalstellen (z.B. SQR(2, 2) → 141 = 1.41) über ein adaptives ungerades Differenzverfahren ohne Division. |
SCREEN 32 / SCREEN 64 |
Matrix-Grafik | Konfiguriert die Zielauflösung und Framebuffer-Basisadresse (960..1023 bei 32×32 bzw. 768..1023 bei 64×64 im Simulator). |
CLS [StartRow, EndRow] |
Matrix-Grafik | Löscht die gesamte LED-Matrix oder selektiv einen Zeilenbereich von StartRow bis EndRow. |
PSET X, Y, C / PLOT X, Y, C |
Matrix-Grafik | Setzt (C=1) oder löscht (C=0) den Pixel (X, Y) mittels O(1) Bitmasken-Lookup-Tabelle (Zeilenwort 0 = rechts X:16..31, Zeilenwort 1 = links X:0..15). |
LINE X1, Y1 TO X2, Y2 [, C] |
Matrix-Grafik | Zeichnet eine Linie beliebiger Steigung mittels hardwarenaher Bresenham-Ganzzahlarithmetik und O(1) Bitmasken-Lookup direkt in die Relais-Matrix. |
PIXELMOVE X, Y TO ZX, ZY / BY DX, DY |
Matrix-Grafik | Bewegt einen aktiven Bildpunkt flimmerfrei absolut (TO) oder relativ (BY) über die Matrix. |
POKE Addr, Val / PEEK(Addr) |
Speicherzugriff | Direkter 16-Bit Schreib- und Lesezugriff auf jede physikalische Speicheradresse (Konstante Adressen werden direkt zu einem einzelnen STAM/LDAM optimiert). |
🧮 Numerische Architektur: Q8.8 Festkomma (FIXED8) & Zuse-Style Gleitkomma (CLACK-F16)
Da der 16-Bit Relaiscomputer keinen Hardware-Barrel-Shifter besitzt (jeder SHL/SHR schiebt exakt 1 Bit in 4 Mikroprogramm-Schritten ≈ 280 ms) und das Hardware-Return-Register SR physisch nur eine einzige Rücksprungebene speichert, stellt der Clack-BASIC Compiler zwei komplementäre 16-Bit Kommazahlen-Formate bereit. Über den Lazy Runtime Linker werden mathematische Laufzeitroutinen nur dann in das 1024-Worte-RAM eingebunden, wenn sie im Programm tatsächlich aufgerufen werden:
| Eigenschaft | INT16 (Ganzzahl) |
FIXED8 (Q8.8 Festkomma) |
FLOAT16 (CLACK-F16 / S1-E7-M8) |
|---|---|---|---|
| BASIC-Deklaration | A = 42 / DIM A AS INT16 |
DIM X AS FIXED8 (oder AS Q8.8) |
X# = 1.5 oder DIM X AS FLOAT16 |
| 16-Bit Wortlayout | [Bit 15: Sign] [Bits 14..0: Int15]Zweierkomplement |
[Bit 15: S] [Bits 14..8: Int7] [Bits 7..0: Frac8]Wert = int16(W) / 256.0 |
[Bit 15: S] [Bits 14..8: Exp7 (Bias 63)] [Bits 7..0: Mant8]Wert = (-1)^S × (1 + M/256) × 2^(E-63) |
| Wertebereich & Auflösung | -32768 .. +32767Schrittweite: 1 |
-128.0000 .. +127.9961Konstante Auflösung: 1/256 = 0.00390625 |
±5.4 × 10⁻²⁰ .. ±9.2 × 10+189 Bit Präzision (8 Bit + implizite 1 ≈ 2,7 Dezimalstellen) |
Addition / Subtraktion (+, -) |
Inline (2–4 Befehle)LDAM + ADD (~0,7–1,5 s) |
Inline (2–4 Befehle, 0 Worte Runtime!) 100% identisch zu INT16 (~0,7–1,5 s) |
Subroutine __f16_add / __f16_subExponenten-Angleich & Normierung (~32 s) |
Multiplikation / Division (*, /) |
__runtime_mul / __runtime_div16-Bit Shift-Add / Restoring Div |
__runtime_fmul_q88 / __runtime_fdiv_q88Skaliert mit >> 8 bzw. << 8 & Sättigung |
__f16_mul / __f16_div8×8→16-Bit Mantissenkern ohne 32-Bit-Überlauf! |
| Idealer Einsatzbereich | Schleifen, Zähler, Adressen, Bitlogik | Schnelle Grafik, Mandelbrot, Geometrie mit bekanntem Wertebereich | Physikalische Formeln, große Dynamikbereiche, allgemeine Fließkommarechnung |
- Warum Zuse-Style
S1-E7-M8statt IEEE 754binary16? Exponent (Bits 14..8) und Mantisse (Bits 7..0) liegen exakt auf Byte-Grenzen, und das Produkt zweier 9-Bit-Mantissen passt bei schrittweiser Shift-Addition direkt in den 16-Bit-Akkumulator – ganz ohne teure 32-Bit-Doppelwort-Arithmetik im RAM. - Sonderfall- & Sättigungspolitik: Die kanonische Null ist
0x0000(1.0 = 0x3F00,-1.0 = 0xBF00,1.5 = 0x3F80,3.75 = 0x40E0). Bei Überlauf (Overflow) sättigen sowohlQ8.8als auchCLACK-F16definiert auf den maximalen darstellbaren Betrag (0x7FFFbzw.0xFFFF); bei Unterflow gehtCLACK-F16sauber auf0x0000. - Automatische Typ-Promotion & 1-Level
SR-Garantie: Gemischte Ausdrücke zwischenINT16und Kommazahlen werden vom Compiler automatisch konvertiert (Konstanten zur Compile-Zeit, Variablen via__f16_itofbzw. 8-Bit-Shift). Sämtliche FPU-Routinen teilen sich einen gemeinsamen Normierungs- und Pack-Block per direktem Sprung (BA) und belegen niemals mehr als die 1 physische Hardware-CALL-Ebene desSR-Registers.
10 REM ========================================================
20 REM CLACK-BASIC: Q8.8 FESTKOMMA & CLACK-F16 GLEITKOMMA DEMO
30 REM ========================================================
40 REM 1. Schnelles Q8.8 Festkomma (Addition direkt in 2 ALU-Befehlen!)
50 DIM AX, BX, CX AS FIXED8
60 AX = 1.5
70 BX = 2.25
80 CX = (AX + BX) * 2.0
90 R_FIXED = FTOI(CX)
100 PRINT "Q8.8 (1.5 + 2.25) * 2.0 -> INT = "; R_FIXED
110 REM --------------------------------------------------------
120 REM 2. CLACK-F16 Gleitkomma (S1-E7-M8) mit #-Suffix & Mixed-Int
130 X# = 1.5
140 Y# = 2.25
150 OFFSET = 4
160 Z# = (X# * Y#) + OFFSET
170 IF Z# > 7.0 THEN R_FLOAT = FTOI(Z#)
180 PRINT "CLACK-F16 (1.5 * 2.25) + 4 -> INT = "; R_FLOAT
190 END
📐 Technischer Deep-Dive: Die divisionsfreie Wurzelfunktion in v1.5.5
Da ein Relaiscomputer für eine Ganzzahl-Division bis zu 32 Zyklen mit Relais-Klickfolgen benötigt, implementiert Clack-BASIC v1.5.5 das Wurzelziehen als divisionsfreien 8-Schritt Bit-für-Bit Algorithmus (Shift-and-Subtract). Für 16-Bit Ganzzahlen benötigt die Berechnung exakt 8 feste Iterationsstufen:
10 REM ========================================================
20 REM CLACK-BASIC v1.5.5 SQR DEMO // 16-BIT RELAISCOMPUTER
30 REM ========================================================
40 CLS
50 PRINT "TEST 1: GANZZAHLIGE WURZELN"
60 FOR X = 1 TO 10
70   Y = SQR(X * X)
80   PRINT "SQRT("; X * X; ") = "; Y
90 NEXT X
100 PRINT "----------------------------------------"
110 PRINT "TEST 2: HOCHPRÄZISE FESTKOMMA-WURZEL"
120 REM SQR(2, 2) berechnet Wurzel 2 mit 2 Nachkommastellen (x100)
130 F = SQR(2, 2)
140 W_INT = F / 100
150 W_DEC = F MOD 100
160 PRINT "SQRT(2) = "; W_INT; "."; W_DEC; " (ERGEBNIS: 1.41)"
170 END
Der Clack-BASIC Compiler übersetzt den Quelltext in die realen 16-Bit Maschinencodes von Peter's Relais-CPU. Fast alle Befehle bestehen aus zwei aufeinanderfolgenden 16-Bit Worten (Opcode-Wort + Operand-Wort im Folgespeicher), mit Ausnahme von NOP, NOT, SHR, SHL und RET.
| Opcode (Hex) | Mnemonic | Operanden | Funktion (RTL) | Mikro-Schritte | Laufzeit (~70 ms/Schritt) |
|---|---|---|---|---|---|
0xF000 | NOP | - | Keine Operation (Idle) | 2 Schritte | ~140 ms |
0x1400 | LDA | val | ACC ← val (16-Bit Sofortwert / Immediate) | 4 Schritte | ~280 ms |
0x1800 | LDAM | addr | ACC ← Mem[addr] (Direktes Laden aus RAM) | 6 Schritte | ~420 ms |
0x1C00 | LDAMM | addr | ACC ← Mem[Mem[addr]] (Indirektes Zeigerladen) | 8 Schritte | ~560 ms |
0x2800 | STAM | addr | Mem[addr] ← ACC (Direktes Speichern) | 6 Schritte | ~420 ms |
0x2C00 | STAMM | addr | Mem[Mem[addr]] ← ACC (Indirektes Zeigerspeichern) | 8 Schritte | ~560 ms |
0x3440 | ADD | val | ACC ← ACC + val, Carry-Flag bei Übertrag | 4 Schritte | ~280 ms |
0x3480 | AND | val | ACC ← ACC & val (Bitweises UND) | 4 Schritte | ~280 ms |
0x34C0 | OR | val | ACC ← ACC | val (Bitweises ODER) | 4 Schritte | ~280 ms |
0x3540 | NOT | - | ACC ← ~ACC (Bitweise Invertierung) | 4 Schritte | ~280 ms |
0x3580 | SHR | - | ACC ← ACC >> 1 (Rechtsschieben um 1 Bit) | 4 Schritte | ~280 ms |
0x35C0 | SHL | - | ACC ← ACC << 1 (Linksschieben um 1 Bit) | 4 Schritte | ~280 ms |
0x4000 | BA | addr | PC ← addr (Branch Always / Unbedingter Sprung) | 4 Schritte | ~280 ms |
0x4008 | BC | addr | IF Carry=1 THEN PC ← addr (Sprung bei Übertrag) | 4 Schritte | ~280 ms |
0x4010 | BN | addr | IF Accu[15]=1 THEN PC ← addr (Sprung bei Negativ) | 4 Schritte | ~280 ms |
0x4018 | BZ | addr | IF Accu=0 THEN PC ← addr (Sprung bei Null) | 4 Schritte | ~280 ms |
0x4020 | BE | addr | IF Accu[0]=0 THEN PC ← addr (Sprung bei Even / Gerade) | 4 Schritte | ~280 ms |
0x5000 | CALL | addr | SR ← PC; PC ← addr (Sichert PC im 10-Bit SR-Register) | 4 Schritte | ~280 ms |
0x6000 | RET | - | PC ← SR (Rücksprung aus Unterprogramm) | 5 Schritte | ~350 ms |
Pseudo | HALT / END | - | Software-Endlosschleife: BA self (0x4000 auf eigene Adresse) | 4 Schritte | ~280 ms (Schleife) |
NOT + ADD 1 + ADD berechnet), MUL, DIV, CMP oder separate Stack-Push/Pop-Operationen. Clack-BASIC übersetzt entsprechende Hochsprachen-Konstrukte automatisch in Folgen dieser realen Hardware-Befehle.
🌌 1. Mandelbrot-Fraktal auf 32×32 Relais-Matrix
Dieses Programm läuft real auf Peter's 16-Bit Relaiscomputer! Es berechnet die Mandelbrot-Menge mittels 16-Bit Festkomma-Arithmetik (Skalierungsfaktor 256) und schaltet die Relais der 32×32 LED-Matrix entsprechend ein.
10 REM ========================================================
20 REM MANDELBROT-MENGE 32x32 FUER PETER'S RELAISCOMPUTER
30 REM 16-Bit Festkomma-Arithmetik (Skalierung: 256 = 1.0)
40 REM ========================================================
50 CLS
60 MAXITER = 16
70 FOR Y = 0 TO 31
80   CI = (Y - 16) * 16
90   FOR X = 0 TO 31
100    CR = (X - 22) * 16
110    ZR = 0
120    ZI = 0
130    FOR I = 1 TO MAXITER
140      ZR2 = (ZR * ZR) / 256
150      ZI2 = (ZI * ZI) / 256
160      IF (ZR2 + ZI2) > 1024 THEN GOTO 220
170      ZI = (ZR * ZI) / 128 + CI
180      ZR = ZR2 - ZI2 + CR
190    NEXT I
200    PSET(X, Y, 1)
210    GOTO 230
220    PSET(X, Y, 0)
230  NEXT X
240 NEXT Y
250 END
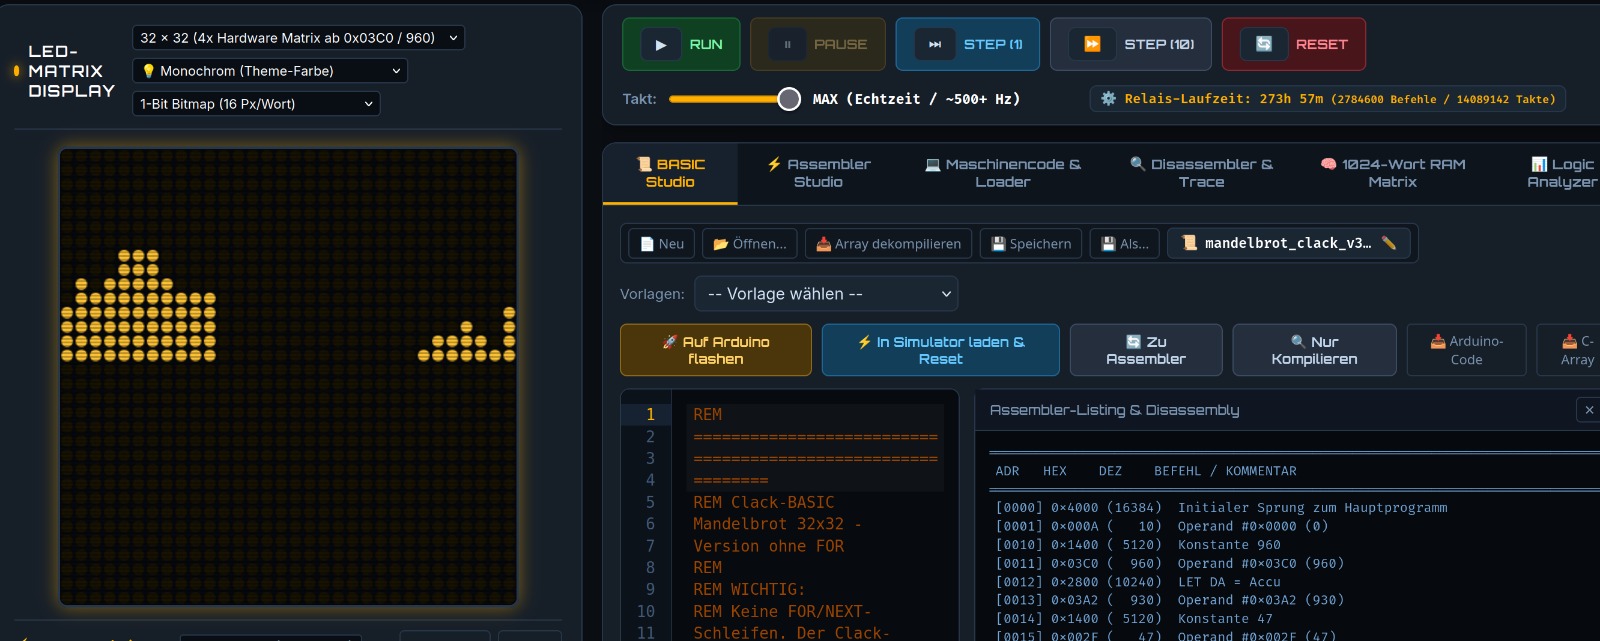
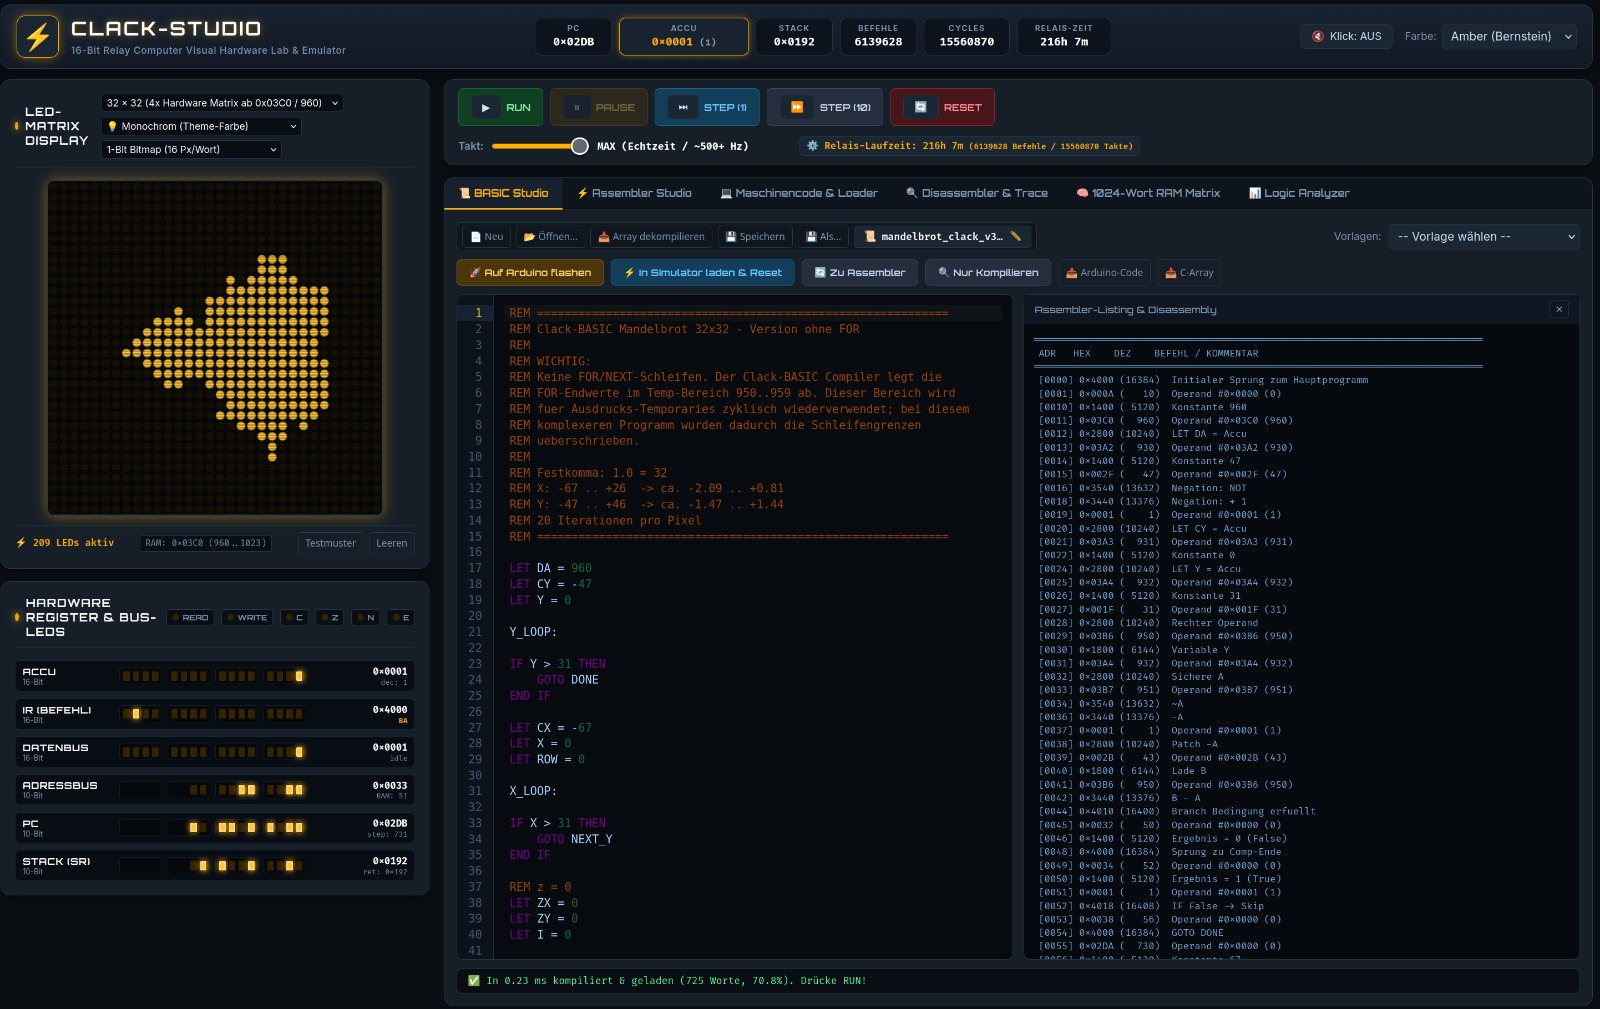
Das Foto zeigt das originale LED-Anzeigefeld des Relaiscomputers nach Durchlauf der obigen Mandelbrot-Berechnung. Die Apfelmännchen-Struktur ist auf den 1024 Relaispunkten scharf erkennbar!
📊 2. Datentabellen & Haltepunkte: DATA, READ, RESTORE & STOP
Demonstriert die sequentielle Werteabarbeitung aus dem Programmspeicher sowie den programmierten CPU-Haltepunkt (STOP) zur Register- und Speicherinspektion.
10 REM ========================================================
20 REM CLACK-BASIC: DATA, READ, RESTORE & STOP DEMO
30 REM ========================================================
40 CLS
50 PRINT "LESE DATENTABELLE EIN:"
60 FOR I = 1 TO 4
70   READ V
80   PRINT "WERT "; I; " = "; V
90 NEXT I
100 PRINT "PROGRAMMIERTER HALTEPUNKT (STOP)..."
110 STOP : REM Hier stoppt die CPU; Register koennen inspiziert werden!
120 PRINT "SETZE DATENZEIGER ZURUECK (RESTORE)..."
130 RESTORE
140 READ FIRST_VAL
150 PRINT "ERSTER WERT ERNEUT GELESEN: "; FIRST_VAL
160 DATA 100, 250, 42, 888
170 END
💻 Clack CLI Schnellstart
Nach dem Download kann der Compiler direkt im Terminal ausgeführt werden:
# Ausführungsrechte vergeben (unter Linux / macOS)
chmod +x clack-linux-amd64

# BASIC Programm kompilieren zu Relais-Maschinencode
./clack-linux-amd64 build mandelbrot.bas -o mandelbrot.bin

# Programm im virtuellen 16-Bit Emulator ausführen
./clack-linux-amd64 run mandelbrot.bas

# Maschinencode disassemblieren
./clack-linux-amd64 disasm mandelbrot.bin